
SEO Читатель аюрведы
Читатель аюрведы — приложение на JavaScript: поисковик видит оболочку, а текст книг появляется только в браузере. Я сделал так, чтобы каждая глава, статья энциклопедии, домашнее средство и термин имели собственный адрес со статическим HTML, русской и английской версией, разметкой и записью в sitemap. Ниже — что именно сделано и что показывают проверки на 15 октября 2026 года.
01 / задача
Всё содержимое сайта лежало внутри приложения — наружу поисковикам отдавалась одна страница
Приложение открывается быстро и удобно читается, но для поиска это один адрес: стихи, главы и статьи подгружаются скриптом. Поэтому по запросу «Аштанга-хридая 1 глава» или «Вата-тип» у сайта почти не было шансов. Задача — отдать поисковику те же тексты обычными HTML-страницами, не ломая приложение и не создавая вторую версию контента вручную.
- Один адрес вместо тысяч: книги, главы и статьи жили внутри приложения
- Нет английской версии: хотя стихи были, языка в адресе и в тегах не было
- Устаревшие цифры в описании главной: «36 786 шлок из 7 самхит», «382 термина», «208 статей»
- Страницы, о которых поисковик мог узнать только из sitemap, без ссылок с главной
02 / хронология
Как рос сайт для поиска: от мета-тегов в июне до 2 507 страниц в октябре
| Дата | Что сделано | Результат |
|---|---|---|
| 6–7 июня 2026 | Домен ayurvedareader.ru в мета-тегах, JSON-LD (WebSite и список книг), Open Graph, картинка для превью, файлы подтверждения Яндекс.Вебмастера и Google Search Console, счётчик Яндекс.Метрики с вебвизором | база для индексации и измерений |
| 4 июля – 11 июля | Первые статические страницы глав и регенерация под новый контент | 75 статических страниц к 31 июля |
| 11 августа | Регенерация страниц глав с учётом переводов | страницы совпадают с содержимым приложения |
| 15 октября | Английские страницы глав, статические страницы энциклопедии, домашних средств и глоссария, обновление главной, IndexNow, Search Console | 2 507 адресов в sitemap |
03 / статические страницы
Один скрипт строит HTML для каждой главы, статьи, средства и термина
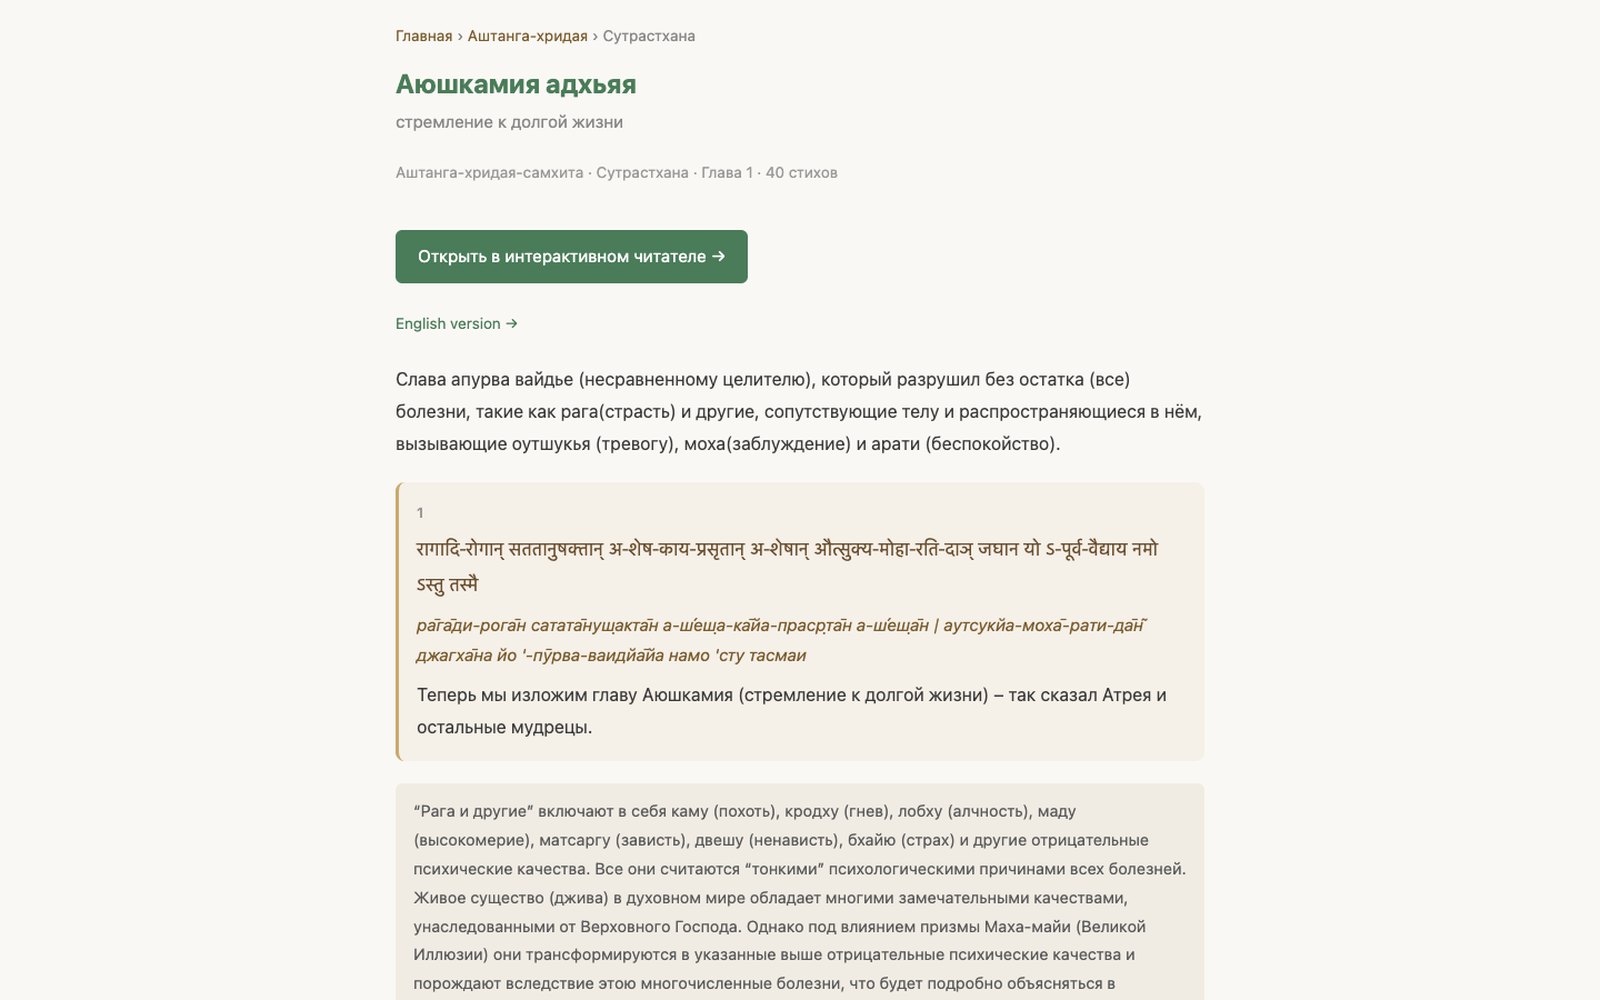
Страницы строит скрипт generate-static-pages из тех же файлов данных, что читает приложение, поэтому текст на странице и в приложении один и тот же. На странице есть заголовок главы, санскрит с транслитерацией и перевод, хлебные крошки, ссылка «Открыть в интерактивном читателе» и переключатель языка; сама читалка по-прежнему открывается одним кликом.
| Тип страницы | Русская / английская | Пример title | Разметка |
|---|---|---|---|
| Глава книги | 841 / 841 | Аюшкамия адхьяя — стремление к долгой жизни | Сутрастхана | Аштанга-хридая-самхита | Chapter (sa, ru) |
| Книга | 9 / 9 | страница книги со списком глав | — |
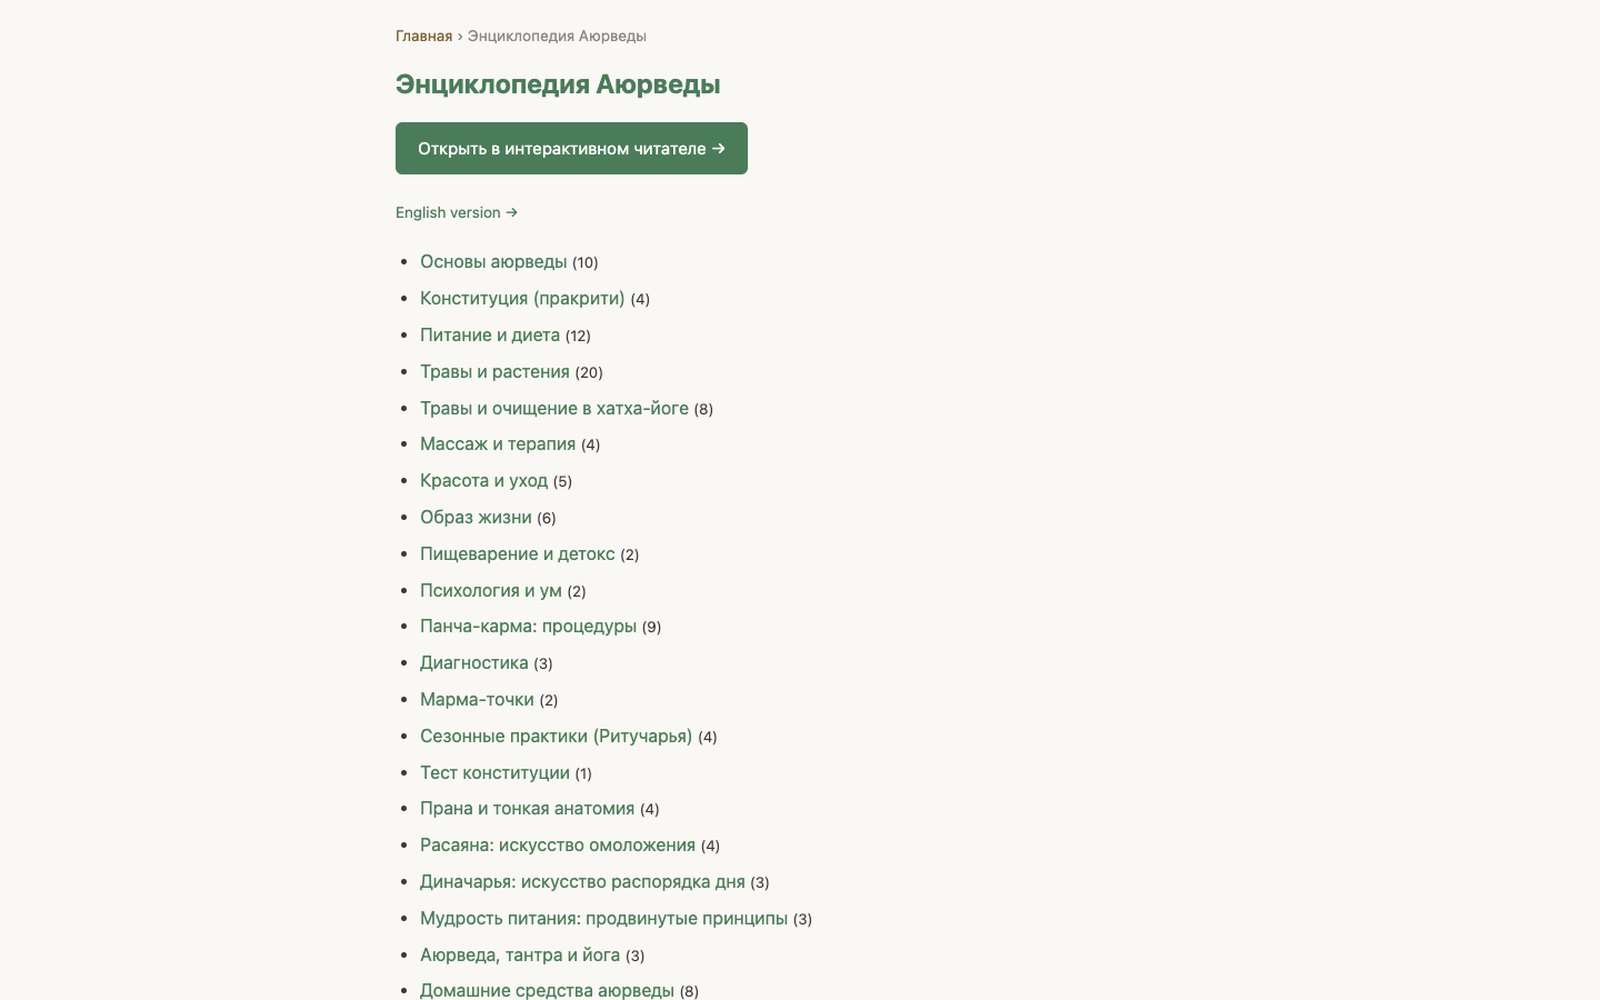
| Энциклопедия | 287 / 287 | Энциклопедия Аюрведы — 241 статей | Article (на статьях) |
| Домашние средства | 114 / 114 | Домашние средства Аюрведы — 113 средств | — |
| Глоссарий | 1 / 1 | Глоссарий Аюрведы — 397 терминов | — |
04 / английская версия
Английские страницы и пары hreflang: поисковик знает, какая версия для кого
У каждой русской страницы есть английская пара и обратная ссылка. Они прописаны и в тегах страницы, и в sitemap, поэтому для запроса на английском поисковик показывает /en/, а для русского — русскую версию. Для главы Мадхавы без единого переведённого стиха английская страница не создаётся: ссылка на несуществующий адрес не появляется.
- Прямые английские названия глав и книг вместо транслита в заголовках
- Английский санскрит-IAST рядом с переводом — стихи читаются так же, как в русской версии
- Переключатель «English version» / «Русская версия» на каждой странице
- Сайт в sitemap с вложенными alternate-ссылками, без дублей
05 / страницы
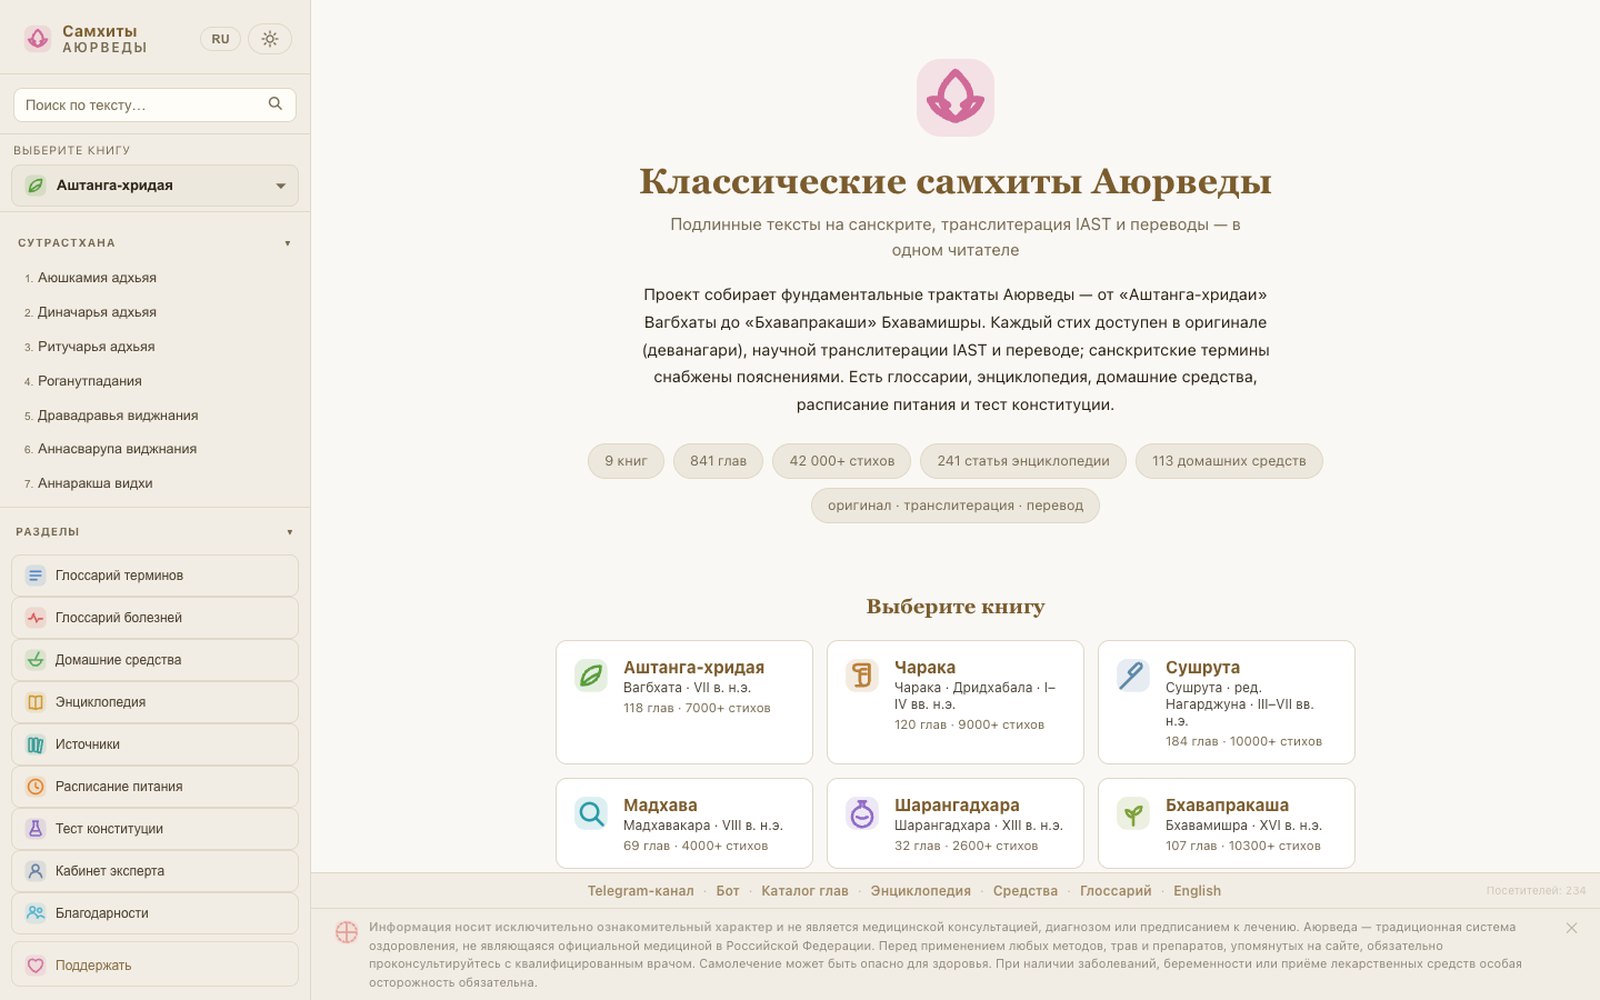
Как выглядит одна и та же книга для читателя и для поисковика

06 / проверка
150 случайных страниц из sitemap: нужные теги стоят почти везде
Я выбрал 150 адресов из sitemap случайным образом и разобрал каждую страницу: код ответа, title, description, h1, canonical, hreflang, Open Graph и JSON-LD. Это выборка, а не полный обход всех 2 507 страниц: полный обход делать нужно после следующей перегенерации.
| Проверка | Результат |
|---|---|
| Код ответа 200 | 150 из 150 |
| Уникальный title | 150 из 150 |
| Ровно один h1 | 150 из 150 |
| Description от 40 символов | 150 из 150 |
| Canonical совпадает с адресом страницы | 150 из 150 |
| hreflang (ru, en, x-default) | 150 из 150 |
| Open Graph | 149 из 150 |
| JSON-LD | 124 из 150 |
07 / разметка
Что описано в JSON-LD: книги, главы и вопросы
На главной три блока разметки. WebSite описывает сайт, ItemList перечисляет все девять книг — каждая как Book с автором и языками, FAQPage — четыре вопроса читателя с ответами. На страницах глав разметка Chapter связывает главу с книгой и указывает языки: санскрит и русский или английский.
| Тип | Где применяется |
|---|---|
| WebSite | главная страница, описание сайта и встроенного поиска |
| ItemList + Book | главная: девять книг с авторами и языками |
| FAQPage | главная: 4 вопроса читателя и ответы |
| Chapter | страницы глав: название, позиция в книге, книга, языки |
| Article | статьи энциклопедии |
08 / индексация
Sitemap, IndexNow и Search Console: как поисковики узнают о страницах
В robots.txt указан sitemap; Google принял его 15 октября, статус «Успешно». Для Яндекса адреса ушли через IndexNow — протокол, который принимают Яндекс и Bing без кабинета. Google IndexNow не поддерживает, поэтому в Search Console добавлен ресурс «Префикс в URL», подтверждённый HTML-файлом, и отправлены запросы на индексацию шести ключевых страниц.
| Страница | Что показал Google до запроса |
|---|---|
| Главная | уже в индексе, запрошена переиндексация обновлённой версии |
| /chapters/ | не в индексе, Google о ней не знал |
| /encyclopedia/ | не в индексе, найдена через sitemap |
| /remedies/ | не в индексе, найдена через sitemap |
| /glossary.html | не в индексе, найдена через sitemap |
| /en/chapters/ | не в индексе, Google о ней не знал |
Яндекс.Вебмастер пока показывает старый sitemap: последняя загрузка 9 октября, 853 ссылки, инструмент временно только для чтения. Новые 2 507 адресов он получил через IndexNow и подхватит sitemap при следующем обходе.
09 / главная страница
На главной исправили цифры и добавили ссылки на статические разделы
Поисковик берёт описание и разметку главной как визитку сайта, поэтому устаревшие цифры исправлены в title, description, Open Graph и JSON-LD. В подвал главной добавлены обычные ссылки на каталог глав, энциклопедию, домашние средства, глоссарий и английскую версию: раньше статические страницы можно было найти только через sitemap.
- Главная теперь ссылается на каталог глав, энциклопедию, средства, глоссарий и English
- В списке книг для поисковиков все девять, а не семь
- На телефоне подвал не ломается и не уезжает
10 / итог и что дальше
Технически SEO готово, результаты в поиске ещё ждут обхода
- Пока нельзя назвать позиции и трафик: страницы только что отправлены, индексация идёт днями и неделями.
- Через 1–2 недели нужно открыть в Search Console раздел «Страницы» и посмотреть, сколько адресов проиндексировано.
- Повторно проверить Яндекс.Вебмастер: число ссылок в sitemap должно вырасти с 853.
- После следующей перегенерации страниц сделать полный обход всех 2 507 адресов, а не выборку.
- В IndexNow отправлять изменённые страницы после каждой перегенерации.
11 / технологии
Из чего это собрано
- Node.js-скрипты: generate-static-pages (страницы), indexnow (уведомление поисковиков), deploy-static (заливка на хостинг)
- Данные: те же файлы книг, что читает приложение — страницы и приложение совпадают по тексту
- Хостинг Beget: статические файлы без сервера; версия скриптов и кэша меняется при каждом релизе
- Проверка: выборка из 150 страниц sitemap, сверка sitemap и ответа сервера
Обсудить проект
Нужно SEO для вашего сайта?
Пришлите адрес сайта — проведу аудит, подготовлю ТЗ на правки и покажу, что исправлять в первую очередь.
Заказать SEO