
SEO Ayurveda Reader
Ayurveda Reader 是一个 JavaScript 应用:搜索引擎只看到外壳,典籍文本只在浏览器里出现。我让每一章、每篇百科文章、每个家庭疗法和每个术语都拥有自己的地址,配有静态 HTML、俄语和英语版本、标记以及 sitemap 条目。下面是具体做了什么,以及截至2026年10月15日的检查结果。
01 / 任务
网站的全部内容都在应用里——搜索引擎只拿到一个页面
应用打开很快、阅读也方便,但对搜索来说它只有一个地址:诗节、章节和文章都由脚本加载。所以搜索“Ashtanga Hridaya 第1章”或“Vata 类型”时,网站几乎没有机会。任务是:用普通 HTML 页面把同样的文字交给搜索引擎,既不破坏应用,也不手工再做一份内容副本。
- 一个地址代替成千上万:典籍、章节和文章都在应用里
- 没有英语版本:诗节有,但地址和标签里没有语言
- 主页描述里的数字过时:“7部本集中的36,786节”“382个术语”“208篇文章”
- 搜索引擎只能通过 sitemap 得知的页面,主页没有链接
02 / 时间线
网站如何为搜索成长:从6月的元标签到10月的2,507个页面
| 日期 | 做了什么 | 结果 |
|---|---|---|
| 2026年6月6–7日 | 在元标签中使用域名 ayurvedareader.ru,JSON-LD(WebSite 与典籍列表)、Open Graph、预览图、Yandex Webmaster 与 Google Search Console 的验证文件、带 Webvisor 的 Yandex Metrica 计数器 | 索引与统计的基础 |
| 7月4日–11日 | 首批章节静态页面,并按新内容重新生成 | 到7月31日共75个静态页面 |
| 8月11日 | 按译文重新生成章节页面 | 页面与应用内容一致 |
| 10月15日 | 英语章节页面,百科、家庭疗法和词汇表的静态页面,更新主页,IndexNow,Search Console | sitemap 中有2,507个地址 |
03 / 静态页面
一个脚本为每章、每篇文章、每个疗法和每个术语生成 HTML
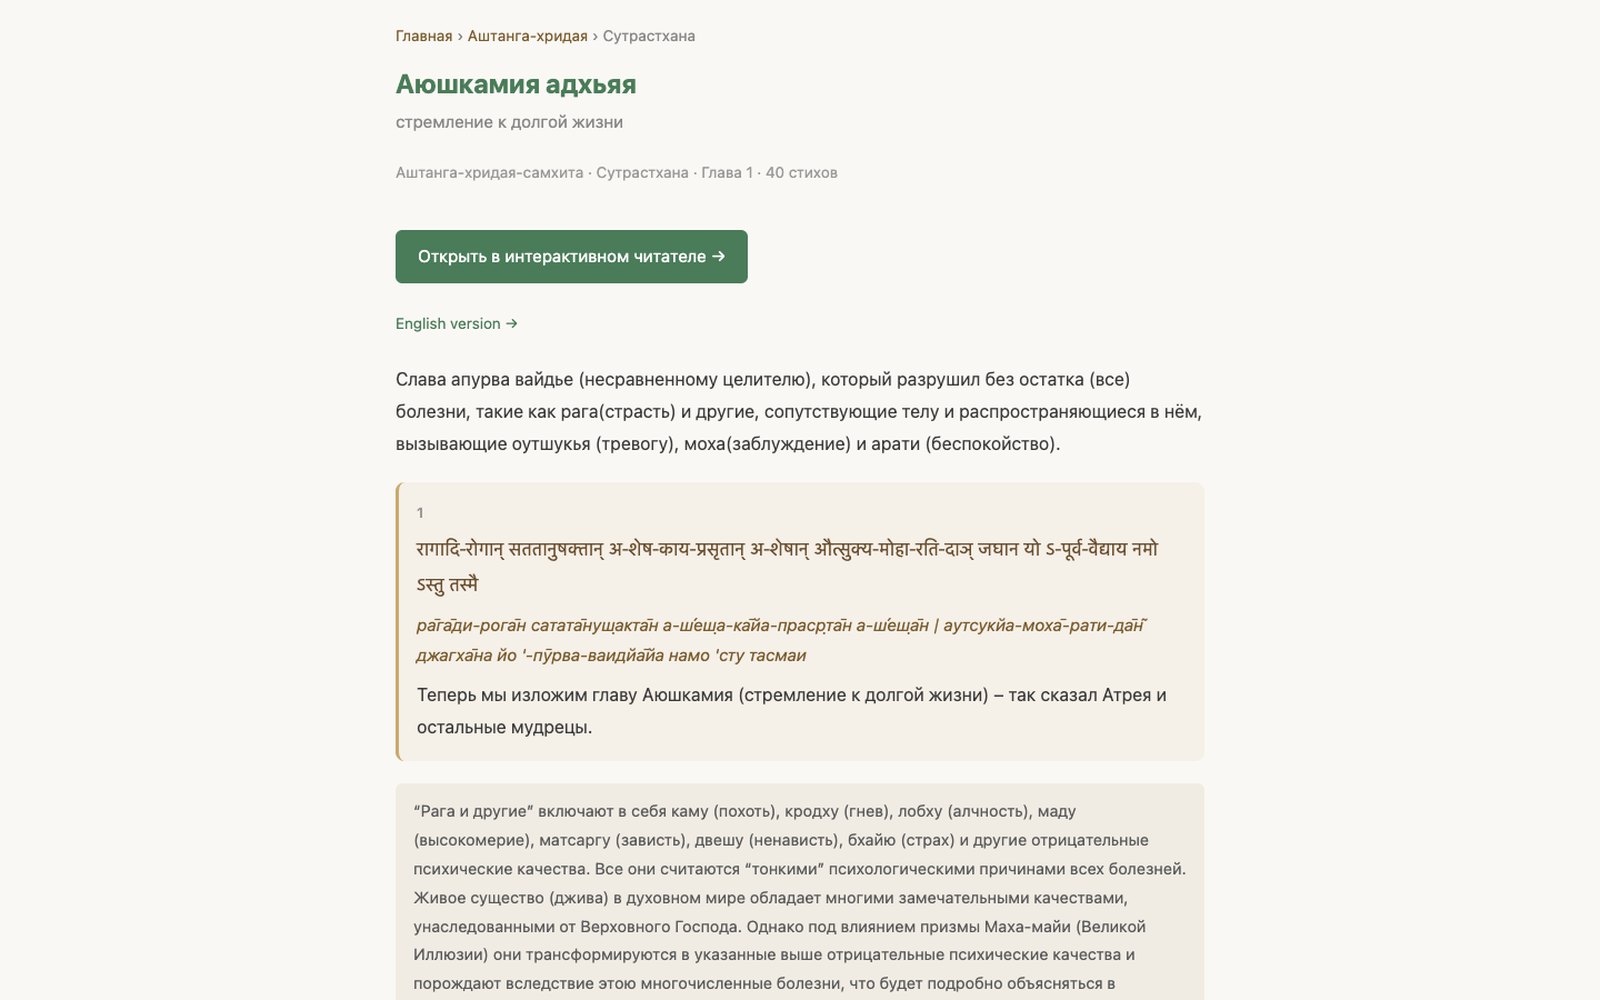
页面由 generate-static-pages 脚本根据应用读取的同一批数据文件生成,所以页面和应用中的文本一致。页面包含章节标题、梵文与转写和译文、面包屑、“在互动阅读器中打开”链接和语言切换;阅读器本身仍可一键打开。
| 页面类型 | 俄语 / 英语 | 标题示例 | 标记 |
|---|---|---|---|
| 典籍章节 | 841 / 841 | Ayushkamiya Adhyaya — the desire for long life | Sutrasthana | Ashtanga Hridaya Samhita | Chapter (sa, ru/en) |
| 典籍 | 9 / 9 | 带章节列表的典籍页面 | — |
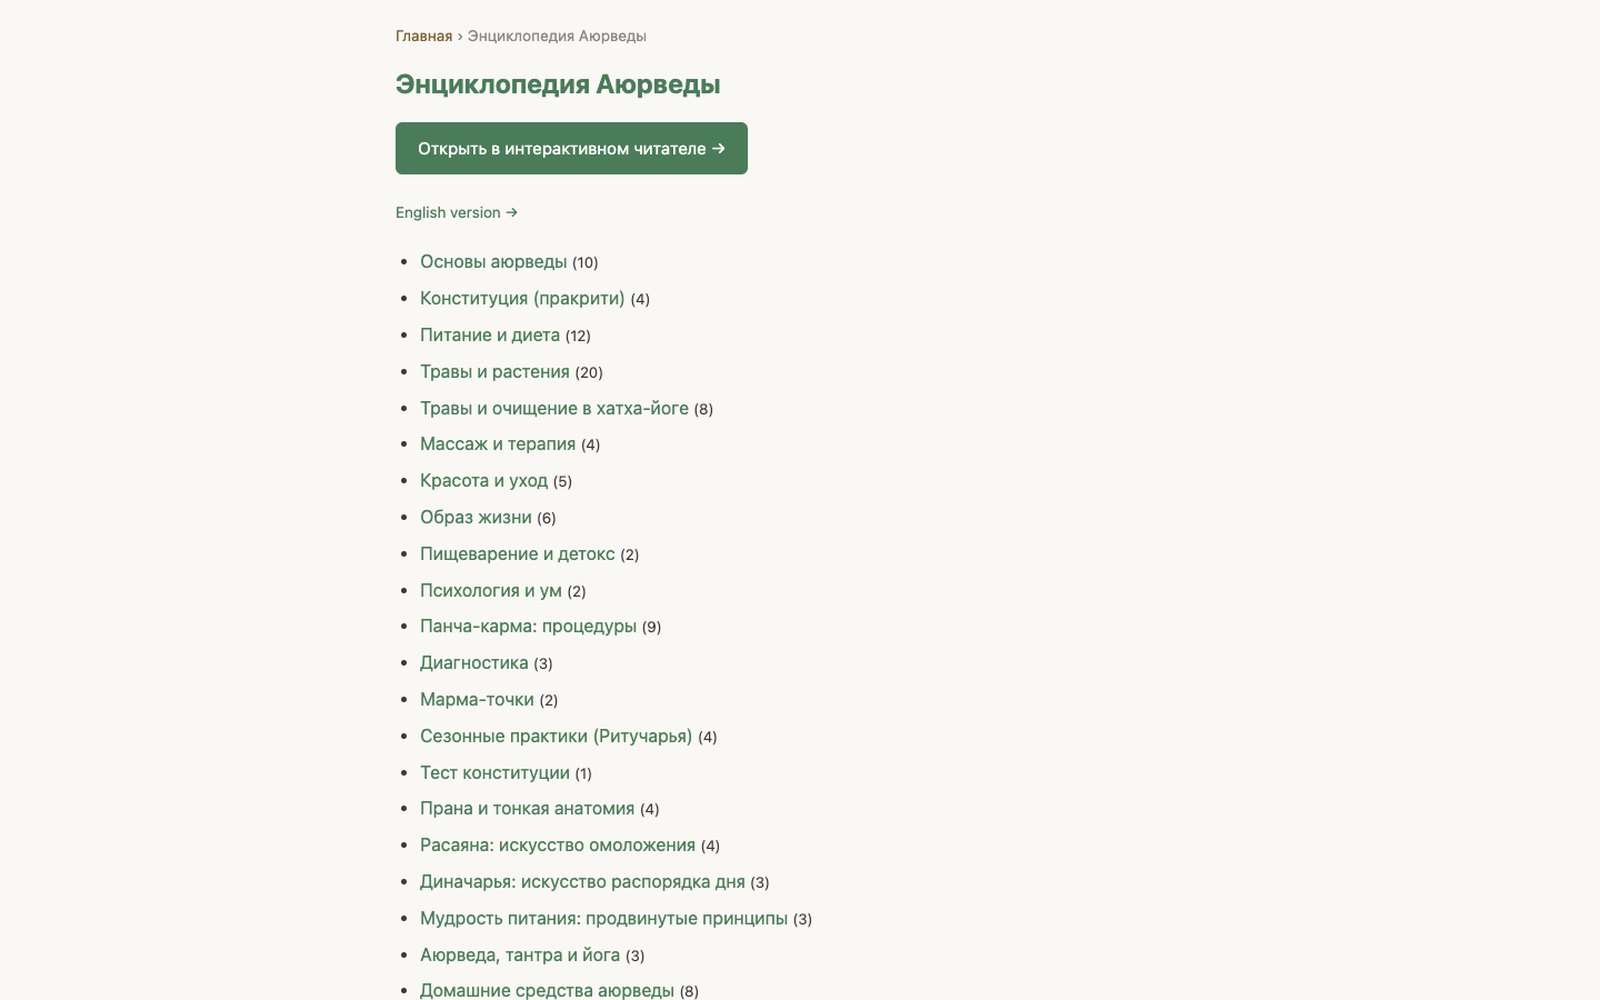
| 百科 | 287 / 287 | 阿育吠陀百科——241篇文章 | Article(文章页) |
| 家庭疗法 | 114 / 114 | 阿育吠陀家庭疗法——113个疗法 | — |
| 词汇表 | 1 / 1 | 阿育吠陀词汇表——397个术语 | — |
04 / 英语版本
英语页面与 hreflang 配对:搜索引擎知道哪个版本给谁
每个俄语页面都有英语配对和反向链接。它们同时写在页面标签和 sitemap 中,所以英语查询时搜索引擎显示 /en/,俄语查询则显示俄语版本。对于没有任何已译诗节的 Madhava 章节,不会创建英语页面:不会出现指向不存在地址的链接。
- 标题中使用英语的章节和典籍名称,而不是转写
- 梵文 IAST 与译文并排——诗节的阅读方式与俄语版本一致
- 每个页面都有“English version” / “Русская версия”切换
- sitemap 中带嵌套的 alternate 链接,没有重复
05 / 页面
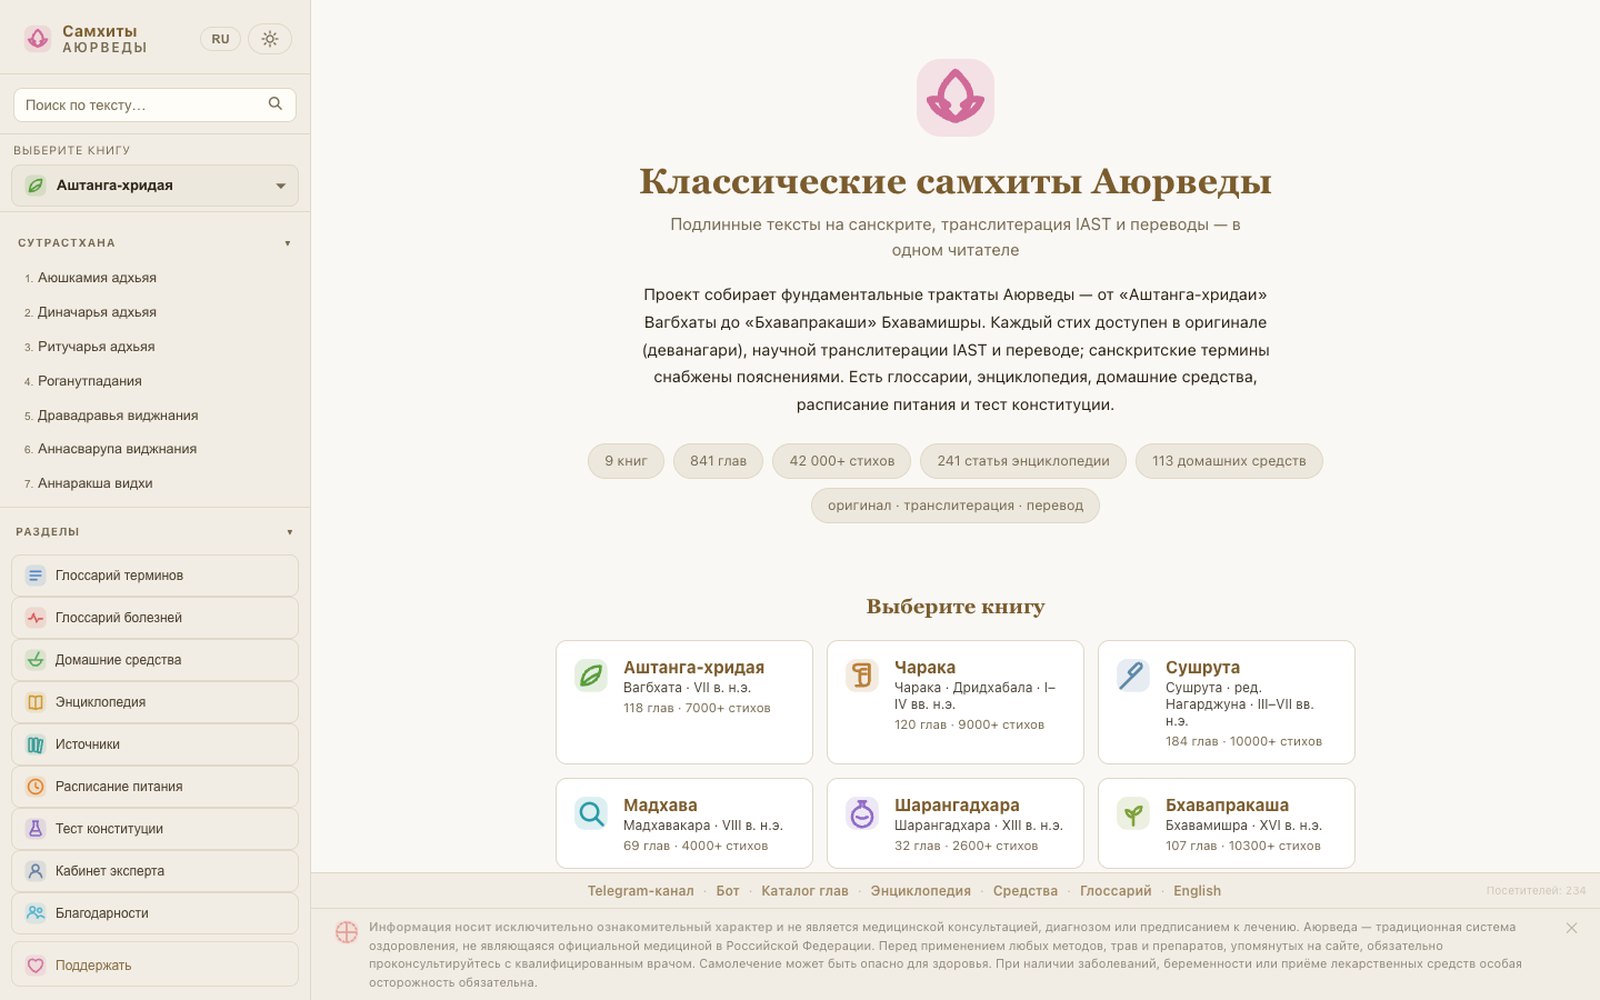
同一部典籍在读者和搜索引擎眼中的样子

06 / 检查
sitemap 中随机抽取的150个页面:所需标签几乎处处都有
我从 sitemap 中随机选取150个地址,逐页检查:响应码、title、description、h1、canonical、hreflang、Open Graph 和 JSON-LD。这是抽样,而不是对全部2,507个页面的完整爬取:下次重新生成后应做完整爬取。
| 检查项 | 结果 |
|---|---|
| 响应码200 | 150中的150 |
| title 唯一 | 150中的150 |
| 恰有一个 h1 | 150中的150 |
| description 不少于40字符 | 150中的150 |
| canonical 与页面地址一致 | 150中的150 |
| hreflang(ru、en、x-default) | 150中的150 |
| Open Graph | 150中的149 |
| JSON-LD | 150中的124 |
07 / 标记
JSON-LD 描述了什么:典籍、章节和问题
主页有三块标记。WebSite 描述网站,ItemList 列出全部九部典籍——每部是带作者和语言的 Book,FAQPage——四个读者问题及答案。章节页面上,Chapter 标记把章节与典籍关联,并标明语言:梵文以及俄语或英语。
| 类型 | 用途 |
|---|---|
| WebSite | 主页,描述网站及其内置搜索 |
| ItemList + Book | 主页:九部典籍及其作者和语言 |
| FAQPage | 主页:4个读者问题及答案 |
| Chapter | 章节页面:标题、在典籍中的位置、典籍、语言 |
| Article | 百科文章 |
08 / 索引
Sitemap、IndexNow 与 Search Console:搜索引擎如何得知页面
robots.txt 指向 sitemap;Google 于10月15日接受,状态为“成功”。对于 Yandex,地址通过 IndexNow 发送——这是 Yandex 和 Bing 无需后台即可接受的协议。Google 不支持 IndexNow,所以在 Search Console 中添加了通过 HTML 文件验证的“网址前缀”资源,并对六个关键页面提交了索引请求。
| 页面 | 请求前 Google 的显示 |
|---|---|
| 主页 | 已收录,已请求重新索引更新后的版本 |
| /chapters/ | 未收录,Google 不知道该页面 |
| /encyclopedia/ | 未收录,通过 sitemap 发现 |
| /remedies/ | 未收录,通过 sitemap 发现 |
| /glossary.html | 未收录,通过 sitemap 发现 |
| /en/chapters/ | 未收录,Google 不知道该页面 |
Yandex Webmaster 仍显示旧 sitemap:最近一次加载在10月9日,853个链接,该工具暂时只读。新的2,507个地址已通过 IndexNow 送达,下次抓取时会读取 sitemap。
09 / 主页
主页更正了数字,并增加了通往静态分区的链接
搜索引擎把主页的描述和标记当作网站名片,所以 title、description、Open Graph 和 JSON-LD 中过时的数字都已更正。页脚中增加了通往章节目录、百科、家庭疗法、词汇表和英语版本的普通链接:此前静态页面只能通过 sitemap 找到。
- 主页现在链接到章节目录、百科、疗法、词汇表和 English
- 给搜索引擎的典籍列表包含全部九部,而不是七部
- 在手机上页脚不会错乱或移位
10 / 结果与下一步
技术上 SEO 已就绪,搜索结果仍在等待抓取
- 目前还不能给出排名和流量:页面刚刚提交,索引需要数天到数周。
- 1–2周后在 Search Console 打开“网页”部分,查看已收录多少地址。
- 再次检查 Yandex Webmaster:sitemap 链接数应从853增加。
- 下次重新生成页面后,对全部2,507个地址做完整爬取,而不是抽样。
- 每次重新生成后,把有变动的页面发送到 IndexNow。
11 / 技术
由什么构成
- Node.js 脚本:generate-static-pages(页面)、indexnow(通知搜索引擎)、deploy-static(上传到主机)
- 数据:应用读取的同一批典籍文件——页面与应用文本一致
- Beget 主机:无服务器的静态文件;每次发布都会更新脚本和缓存版本
- 检查:对 sitemap 中150个页面抽样,并核对 sitemap 与服务器响应
洽谈项目